Approche de modélisation bayésienne
Nous avons développé un modèle statistique pour estimer la couverture sanitaire au niveau national et pour les régions infranationales jusqu’à l’année la plus récente disposant de données, et pour réaliser des prévisions à court terme pour les années à venir.
En bref
- Répond à : Quelle est la meilleure estimation de la couverture pour chaque année, au niveau national et pour les régions infranationales, jusqu’à l’année la plus récente disposant de données et pour les années à venir, et avec quelle incertitude ?
- Utilise : les données d’enquête (leurs niveaux de couverture, pondérés selon leur incertitude) et les données de routine des établissements (uniquement leur tendance d’une année à l’autre, issues de la Couverture nationale), avec le score moyen de qualité des données du Countdown issu de l’Évaluation de la qualité des données.
- Produit : pour la CPN4, les accouchements institutionnels et la couverture vaccinale (trois doses de pentavalent), une meilleure estimation pour chaque année avec un intervalle d’incertitude à 95 %, au niveau national et par région, et des prévisions à court terme. Étape suivante : Évaluation de l’équité (equiplots).
- Dans les applications : Analyse bayésienne (application RMNCAH uniquement).
Pourquoi c’est important
Des informations fiables sur les indicateurs de couverture en santé sont essentielles pour suivre les progrès, orienter les programmes et guider les décisions politiques. Cependant, s’appuyer uniquement sur les données d’enquête et de routine est souvent difficile. Les données de routine provenant des établissements peuvent souffrir de sous-déclaration ou d’une qualité de données incohérente, tandis que les données d’enquête peuvent être incertaines ou pas récentes.
Pour relever ces défis, des modèles statistiques peuvent être utilisés pour produire des estimations et des prévisions au fil du temps, en combinant plusieurs sources de données et en tenant compte de leurs limites. Cela produit des estimations de couverture chaque année (entre les points de données et les données passées) avec une indication de la certitude/incertitude que nous avons pour chaque année. En conséquence, les modèles permettent des évaluations de la couverture sanitaire plus complètes, plus précises et plus opportunes, en particulier dans des contextes de données limitées.
Le modèle est l’outil à utiliser lorsque les enquêtes sont anciennes ou peu nombreuses et que les données des établissements sont imparfaites, et qu’une tendance unique et défendable est nécessaire, par exemple pour un rapport de synthèse.
Méthode
Production des estimations et des prévisions à court terme
Le modèle examine les données disponibles et identifie différentes façons dont la couverture aurait pu évoluer au fil du temps. Chacun de ces chemins possibles est appelé une trajectoire (voir la figure dans la section sur l’utilisation des données d’enquête).
Pour chaque année, nous publions une meilleure estimation (la valeur médiane entre toutes les trajectoires) et une plage qui montre l’incertitude (en excluant les possibilités les plus extrêmes à la marge).
S’appuyant sur des analyses mondiales, le modèle capture que la couverture augmente généralement, au fil du temps, de niveaux bas à niveaux élevés, suivant une tendance en forme de S, avec des périodes de progrès plus rapides ou plus lents selon ce que les données indiquent. Il utilise les données d’enquête et de routine pour choisir des trajectoires qui correspondent à ce qui a été observé. Le modèle s’appuie également sur des tendances constatées dans d’autres zones avec des niveaux de couverture similaires.
Comment les données d’enquête sont-elles utilisées ?
Les données d’enquête nous aident à comprendre la couverture, mais elles comportent une certaine incertitude. Cela se produit car les enquêtes incluent seulement un échantillon de la population, pas tout le monde, et des erreurs peuvent survenir lors de la collecte des données.
Pour tirer le meilleur parti des données d’enquête, le modèle tente de trouver le bon équilibre — en lissant les fluctuations aléatoires qui ne sont probablement pas réelles, tout en capturant les motifs importants dans les données. Pour ce faire, le modèle examine l’incertitude de chaque point de données :
- Forte incertitude : si un point de données est très incertain, il aura moins d’impact sur la couverture estimée (le modèle lui attribue moins de poids et a plus tendance à le lisser).
- Forte fiabilité : si un point de données est plus fiable, les estimations s’aligneront plus étroitement sur cette valeur.
Pour les régions infranationales, le modèle utilise les données d’enquête de la région spécifique lorsque disponibles.
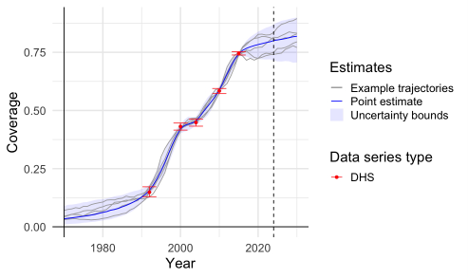 Trajectoires possibles de la couverture au fil du temps selon les données d'enquête
Comment les données de routine sont-elles utilisées ?
Les estimations de couverture issues des données de routine peuvent être biaisées, donc le modèle les traite différemment des données d’enquête. Pour les enquêtes, le modèle utilise les niveaux réels de couverture. Par exemple, si une enquête indique une couverture de 60 % pour une année donnée, le modèle utilise cette valeur directement.
En revanche, les données de routine peuvent être biaisées en raison de problèmes tels que la déclaration incomplète et les incohérences de collecte des données. Pour cette raison, le modèle ne se base pas sur les niveaux de couverture observés dans les données de routine. Au lieu de cela, le modèle se concentre sur la tendance dans le temps — spécifiquement, comment la couverture change d’une année à l’autre.
- Exemple : si les données de routine montrent une couverture passant de 50 % en 2020 à 53 % en 2021, le modèle interprète cela comme une augmentation de 3 points de pourcentage. Si les données de routine montrent des changements plus rapides ou plus lents que prévu, le modèle ajuste les estimations — mais seulement dans la mesure où les données peuvent être considérées comme fiables.
Prise en compte de la qualité des données
Le modèle tient compte de la qualité des données de routine en ajustant l’incertitude des estimations de tendance. Les observations de moindre qualité de données sont traitées comme plus incertaines et reçoivent moins de poids dans la détermination des taux de changement réels. Plus précisément, l’incertitude de la variation estimée augmente à mesure que le score moyen de qualité des données du Countdown diminue. Par conséquent, les données de moindre qualité exercent moins d’influence sur le taux de variation modélisé.
Interprétation
Exemples illustratifs
Les estimations sont produites pour :
- La proportion de femmes qui reçoivent le minimum recommandé d’au moins quatre visites de soins prénatals pendant la grossesse (CPN4).
- La proportion de naissances vivantes qui ont lieu dans un établissement de santé (Accouchements institutionnels).
- La proportion d’enfants qui reçoivent les trois doses recommandées du vaccin pentavalent (Couverture vaccinale).
Exemple 1 : couverture de la CPN4
Un exemple du résultat pour la couverture de la CPN4 au niveau national est présenté dans la figure ci-dessous. Le graphique affiche les données d’enquête et les données de routine sous forme de points (gris pour les données de routine, rouge pour les données d’enquête).
La ligne rouge représente les estimations ponctuelles modélisées, et les zones ombrées en rouge représentent les intervalles d’incertitude à 95 %.
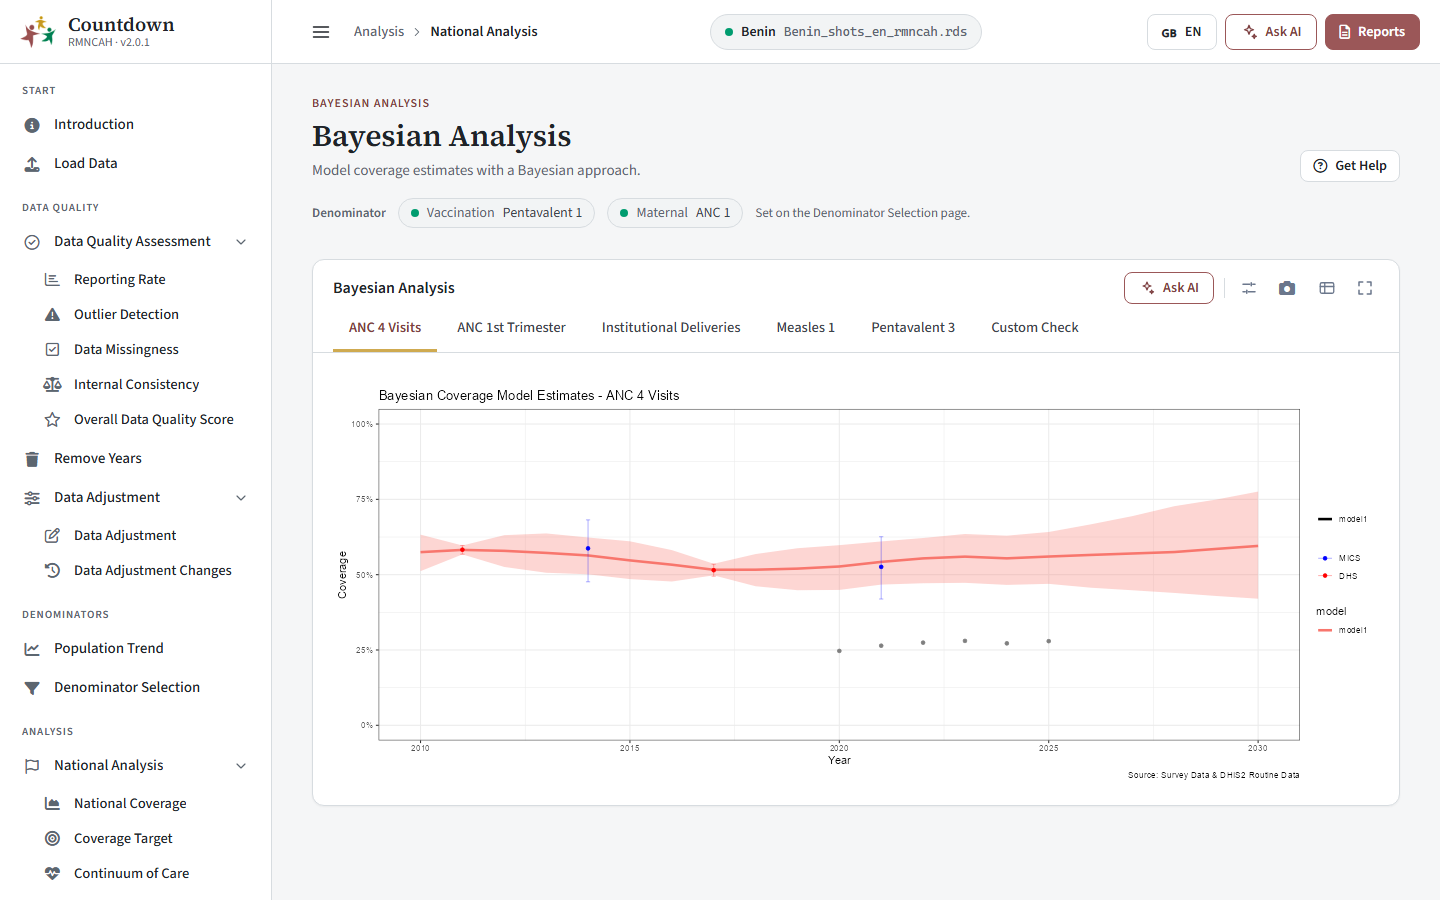 Couverture nationale de la CPN4 avec données d'enquête, données de routine et estimations bayésiennes
Exemple 2 : couverture infranationale de la CPN4
Des résultats d’exemple pour l’estimation de la couverture infranationale pour 2025 sont présentés dans la figure ci-dessous.
Les points rouges représentent les estimations ponctuelles, et les lignes horizontales représentent les intervalles d’incertitude à 95 %.
 Estimations de la couverture infranationale de la CPN4 avec intervalles d'incertitude à 95 %
Exemple 3 : données et estimations bayésiennes
La figure ci-dessous montre des données d’exemple et des estimations obtenues à partir du modèle pour un indicateur de couverture dans quatre régions différentes.
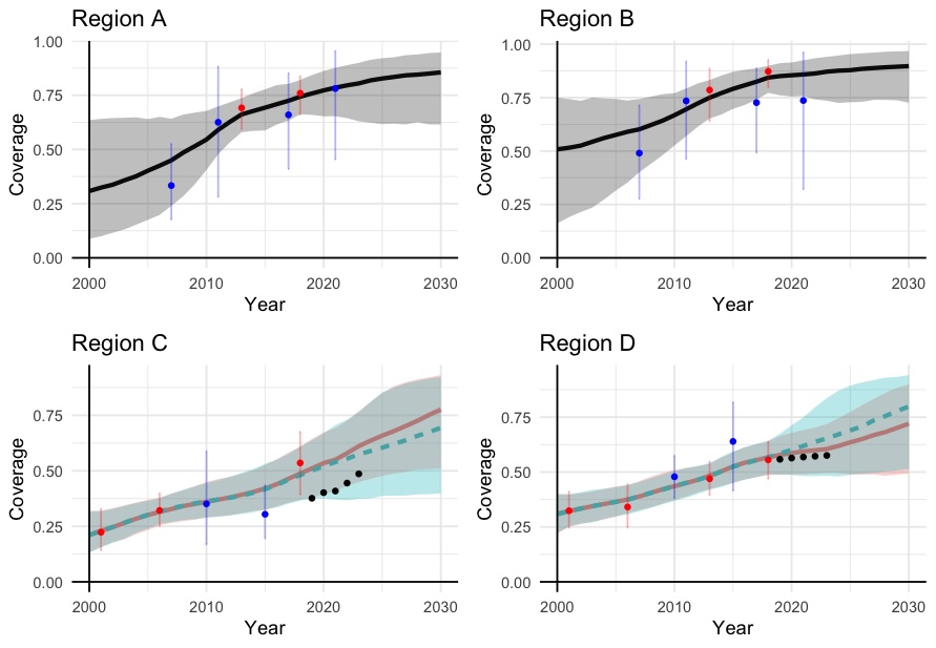 Données d'enquête, données de routine et estimations bayésiennes pour quatre régions
Interprétation
- Les données d’enquête du DHS et du MICS sont présentées en rouge et en bleu, avec des barres verticales indiquant l’incertitude de chaque point d’enquête. Les données de routine sont présentées en noir. Les lignes représentent les estimations ponctuelles du modèle avec des zones ombrées mettant en évidence l’incertitude (en rouge si les données de routine ont été incluses, en noir/vert sinon).
- Les graphiques montrent que les estimations du modèle suivent généralement les données d’enquête, sauf si un point de données est très incertain et ne correspond pas à la tendance générale.
- Par exemple, dans la Région B, le point d’enquête MICS le plus récent est plus bas que prévu et très incertain, donc les estimations récentes du modèle ne s’alignent pas exactement sur cette enquête.
- On constate également que les données de routine aident à renseigner la rapidité à laquelle la couverture évolue dans le temps, en particulier après l’enquête la plus récente, lorsqu’aucune nouvelle donnée d’enquête n’est disponible.
- Région C : les données de routine montrent une augmentation de la couverture. En conséquence, les estimations qui incluent les données de routine montrent un taux de changement plus rapide pendant cette période par rapport aux estimations basées uniquement sur les données d’enquête.
- Région D : les données de routine suggèrent que la couverture n’a pas augmenté récemment, et les estimations qui incluent les données de routine reflètent cette information.
Lecture des estimations
Une bande étroite signifie que les données concordent ; une bande large signifie peu de points de données ou des points contradictoires. L’estimation suit la hausse en forme de S typique de la couverture. Ne considérez pas le modèle comme un substitut à de bonnes données : si le score de qualité des données de routine est faible, l’estimation s’appuie davantage sur les enquêtes.
Pièges courants
- Utiliser les estimations bayésiennes sans indiquer qu’elles sont modélisées. Signalez-le dans les rapports.
Dans les applications
Ouvrez l’Analyse bayésienne
Dans l’application RMNCAH, le groupe Analyse bayésienne de la barre latérale comporte deux entrées : Analyse nationale et Analyse infranationale (régions). L’application Vaxx ne comporte pas ces pages.
Choisissez un onglet d’indicateur
Chaque onglet correspond à un indicateur pour lequel le modèle est défini : Analyse bayésienne en donne la liste.
Lisez le graphique
La courbe centrale est la meilleure estimation et la bande représente la plage d’incertitude ; Télécharger le graphique et Télécharger les données se trouvent dans la barre d’outils. Indiquez que les estimations sont modélisées lorsque vous les utilisez dans des rapports.
Voir aussi
- Analyse bayésienne dans le guide de l’application
- Évaluation de la qualité des données : le score de qualité des données qui détermine le poids de la tendance des données de routine
- Étape précédente : Couverture nationale
- Étape suivante : Évaluation de l’équité (equiplots)