Ajustement des données
Les rapports manquants et les erreurs de données faussent l’analyse de la couverture, en particulier lorsque les taux de notification sont faibles ou sporadiques. Ce module applique des corrections fondées sur des preuves pour transformer les nombres bruts déclarés en estimations justifiables, en tenant compte des établissements qui ne font pas de déclaration et en supprimant les valeurs aberrantes extrêmes. En utilisant un facteur d’ajustement fondé sur des bases scientifiques — basé sur des hypothèses concernant les volumes de services relatifs dans les établissements déclarants par rapport aux non-déclarants — DataSuite augmente proportionnellement les nombres pour refléter la véritable couverture au niveau de la population.
En bref
- Répond à : Comment corriger les nombres déclarés pour les rapports incomplets, les valeurs aberrantes extrêmes et les valeurs manquantes, afin de ne pas sous-estimer la couverture ?
- Utilise : l’exhaustivité des rapports, les valeurs aberrantes extrêmes et les valeurs manquantes évaluées lors de l’évaluation de la qualité des données, et le facteur d’ajustement fixé par l’analyste.
- Produit : les nombres ajustés (), un jeu de données maître ajusté (
.dta), utilisés comme numérateurs des statistiques de couverture dans l’évaluation et la sélection du dénominateur et la couverture nationale. - Dans les applications : Préparation des données (Supprimer les années, Ajustement des données et Changements d’ajustement).
- Valeurs par défaut : Valeurs par défaut et seuils : ajustement des données
Pourquoi c’est important
La stratégie d’ajustement est pragmatique : si nous supposons que tous les établissements non déclarants ont fourni zéro service, nous sous-estimons considérablement la couverture réelle. Au lieu de cela, le module estime la proportion de services qui ont probablement eu lieu dans les établissements silencieux (une part k du volume des établissements déclarants, fixée par l’analyste ; la valeur par défaut du guide Countdown est 25 %) et s’ajuste en conséquence. Lorsque la notification d’un district pour un mois est extrêmement faible (inférieure à 75 %) ou manquante, son taux de notification est remplacé par la médiane des taux du district compris entre 75 % et 100 % avant l’ajustement, afin que quelques mois très incomplets ne produisent pas d’estimations impossibles (voir Règles de seuil de données critiques).
Justification : base scientifique de l’analyse
L’exhaustivité des rapports institutionnels peut fortement fausser l’analyse de la couverture, en particulier si les niveaux de notification sont faibles ou fluctuent considérablement d’une année à l’autre.
De même, les valeurs aberrantes extrêmes — comme un zéro supplémentaire saisi accidentellement lors de la saisie des données — peuvent avoir un impact disproportionné, en particulier sur les mesures infranationales. Suite à nos évaluations de base de la qualité des données, des mesures correctives sont nécessaires pour générer un ensemble de données propre et standardisé pour l’analyse finale. Cela nécessite un ajustement mathématique pour les rapports incomplets et la résolution des valeurs aberrantes extrêmes.
Pour l’argumentation complète, consultez Exhaustivité des rapports : justification et Valeurs aberrantes extrêmes : justification.
Méthode
Approche : description des étapes analytiques
Si nous n’ajustons pas l’exhaustivité des rapports, nous supposons implicitement que tous les établissements non déclarants ont fourni zéro service de santé pendant leurs périodes de silence, ce qui est statistiquement improbable.
Les ajustements dépendent de l’estimation du volume réel de services (par exemple, soins prénatals, vaccinations) fournis dans les établissements non déclarants par rapport à ceux qui ont soumis des données. Pour ce faire, nous établissons un facteur d’ajustement, noté .
Le facteur d’ajustement est défini comme le rapport entre le volume de services fournis par les établissements non déclarants et le volume de services fournis par les établissements déclarants. Ce facteur est utilisé directement pour augmenter les nombres déclarés afin de compenser les lacunes des rapports incomplets.
Formules et paramètres d’ajustement du numérateur
Pour tenir compte avec précision des rapports incomplets, le nombre brut d’événements déclarés est ajusté en utilisant à la fois la proportion d’exhaustivité des rapports et le ratio du volume de services des établissements via l’équation suivante :
Où :
- : nombre total estimé d’événements de santé ajusté pour les rapports incomplets.
- : nombre brut d’événements signalés dans le système.
- : exhaustivité des rapports (exprimée comme la proportion de rapports d’établissements attendus réellement reçus).
- : le facteur d’ajustement tenant compte des volumes de services relatifs plus faibles dans les établissements non déclarants.
Configuration du facteur
Un nouveau jeu de données commence à k = 0 (aucun ajustement) jusqu’à ce que l’analyste fixe k pour chaque service sur la page Ajustement des données. La valeur par défaut du guide Countdown est k = 0.25, ce qui suppose que les établissements non déclarants sont actifs mais fonctionnent à une capacité inférieure, fournissant un volume de services équivalent à exactement un quart (25 %) d’un établissement déclarant moyen.
Cependant, le facteur peut être ajusté manuellement pour différents services en fonction du contexte du système. Par exemple, si les établissements de santé privés ont un faible respect des obligations de déclaration mais gèrent une grande part des accouchements au niveau national, peut être augmenté au-dessus de 0,25, ou fixé jusqu’à 1,0. Plus généralement, augmentez un facteur lorsque des établissements qui notifient mal, par exemple privés, assurent une grande part de ce service ; conservez la valeur par défaut du guide de 0,25, sauf si vous avez des éléments montrant que les établissements qui ne notifient pas assurent une autre part des services.
Selon les infrastructures locales, vous pouvez choisir parmi les niveaux de valeur k suivants :
k = 0.00– Aucun service fourni dans les établissements non déclarants.k = 0.25– Quelques services fournis, mais à un volume bien inférieur à celui des établissements déclarants (valeur par défaut du guide).k = 0.50– Services fournis à la moitié du taux par rapport aux établissements déclarants.k = 0.75– Services fournis à un taux presque identique à celui des établissements déclarants.k = 1.00– Services fournis exactement au même taux que les établissements déclarants.
Les analyses RMNCAH et de vaccination diffèrent ici : k se fixe par service : quatre facteurs k dans les analyses RMNCAH (CPN, accouchement, vaccins et consultations externes), trois dans les analyses de vaccination (CPN, accouchement et vaccins) ; voir Choisissez les facteurs K. Voir Analyses RMNCAH et vaccination.
Règles de seuil de données critiques
- La règle des 75 % d’exhaustivité : si le taux de notification d’un district pour un service est inférieur à 75 % un mois donné (ou manquant), ce taux n’est pas utilisé tel quel : il est remplacé par la médiane des taux de notification du district compris entre 75 % et 100 % pour ce service. Le nombre déclaré du mois est ensuite ajusté avec le facteur d’ajustement comme d’habitude : aucun mois n’est laissé sans ajustement, et le nombre déclaré lui-même est conservé. (Le guide de vaccination Countdown de 2024 formule cette règle à la fois comme « aucun ajustement en dessous de 75 % » et comme « valeur médiane imputée » ; la règle ci-dessus est celle qu’appliquent les applications.)
- Correction des valeurs aberrantes : une valeur mensuelle qui s’écarte de plus de 5 fois le MAD de la valeur médiane mensuelle du district (médiane et MAD calculés sur toutes les années sauf la plus récente) est une valeur aberrante extrême ; elle est remplacée par la médiane des autres mois (non aberrants) du district la même année.
Résumé des règles de gestion de l’ajustement des données
| Problème observé | Critères d’identification et de seuil | Action corrective imputée |
|---|---|---|
| Taux de notification extrêmement faibles | Un taux de notification mensuel de district pour un service inférieur à 75 % (seuil par défaut), ou manquant. | Le taux est remplacé par la médiane des taux de notification du district compris entre 75 % et 100 % pour ce service ; le nombre déclaré du mois est ensuite ajusté avec comme ci-dessous. |
| Lacunes de rapports incomplets | Les taux de notification se situent entre 75 % et 100 %. | Le facteur d’ajustement (fixé par l’analyste ; l’application commence à 0, le guide suggère 0.25) est appliqué pour augmenter les nombres bruts et compenser les établissements non déclarants. |
| Valeurs aberrantes extrêmes | Une valeur mensuelle qui s’écarte de plus de 5 fois l’écart absolu médian () de la valeur médiane mensuelle du district (médiane et calculés sur toutes les années sauf la plus récente). | La valeur extrême est remplacée par la médiane des autres mois (non aberrants) du district la même année. |
| Valeurs manquantes | Champs de données nuls ou vides découverts au cours d’une période de notification active. | Le champ manquant est imputé avec la valeur mensuelle médiane du district pour cette année spécifique. |
Dans les analyses RMNCAH, les indicateurs de mortalité ne sont pas ajustés pour la notification ni pour les valeurs aberrantes, car les décès sont peu nombreux et volatils (voir Mortalité).
Supprimer les années
Le panneau de configuration Supprimer les années vous permet d’exclure complètement des années civiles spécifiques du pipeline de traitement actif. Cet outil est conçu pour supprimer les années qui ne contiennent aucune donnée de notification, ou dont les données ont été explicitement signalées comme inaptes à l’analyse par l’équipe technique nationale en raison de problèmes de qualité graves et systémiques.
Ne supprimez une année que lorsque les contrôles de qualité des données la montrent manifestement erratique ou inutilisable — par exemple une année avec presque aucune notification ou une défaillance connue ou généralisée du système — et que vous avez une raison concrète de le croire. Sans raison, conservez l’année.
Il est fortement recommandé d’utiliser cette fonctionnalité lorsque :
- La base de référence quantitative de la qualité des données se situe bien en dessous des seuils standard acceptables.
- L’équipe de pays possède des informations contextuelles suffisantes et vérifiées (par exemple, des échecs majeurs de déploiement à l’échelle du système, des pannes de réseau prolongées ou des événements de corruption de base de données) qui rendent les données de cette année spécifique complètement non fiables ou inexactes.
La suppression stratégique de ces blocs historiques corrompus garantit que vos chronologies de couverture et évaluations de tendances ultérieures sont construites exclusivement sur une base de données robuste et fiable.
Interprétation
Sorties d’ajustement
Cette section produit un jeu de données maître ajusté (.dta) prêt pour l’analyse, ainsi que des graphiques pour différents indicateurs montrant l’effet des ajustements de données. L’image ci-dessous montre la sortie d’ajustement après n’avoir effectué aucun ajustement sur les données.
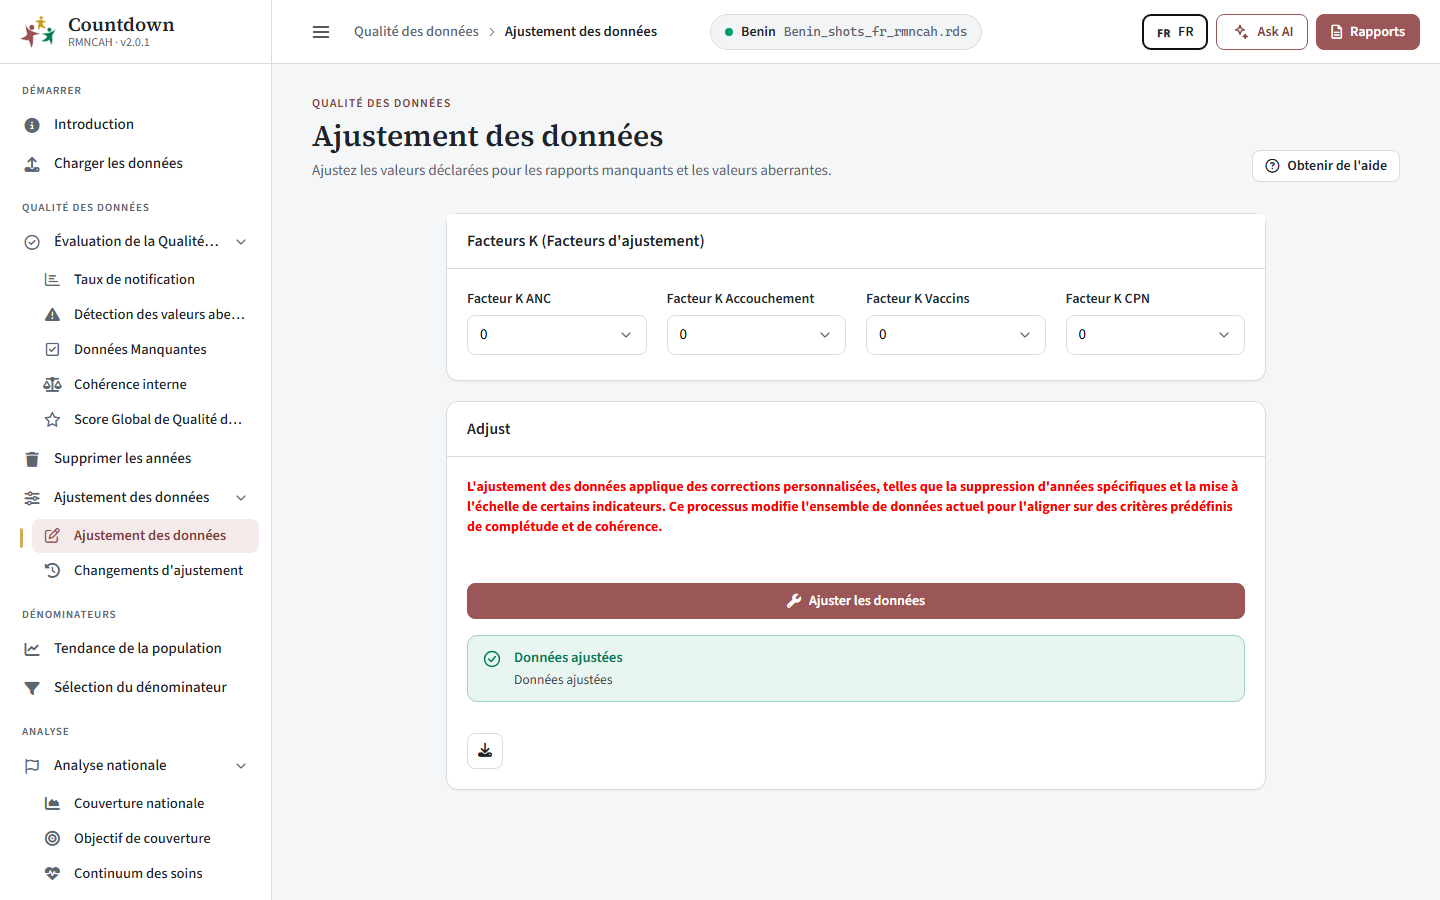 Écran d'ajustement des données avec sélection du facteur k
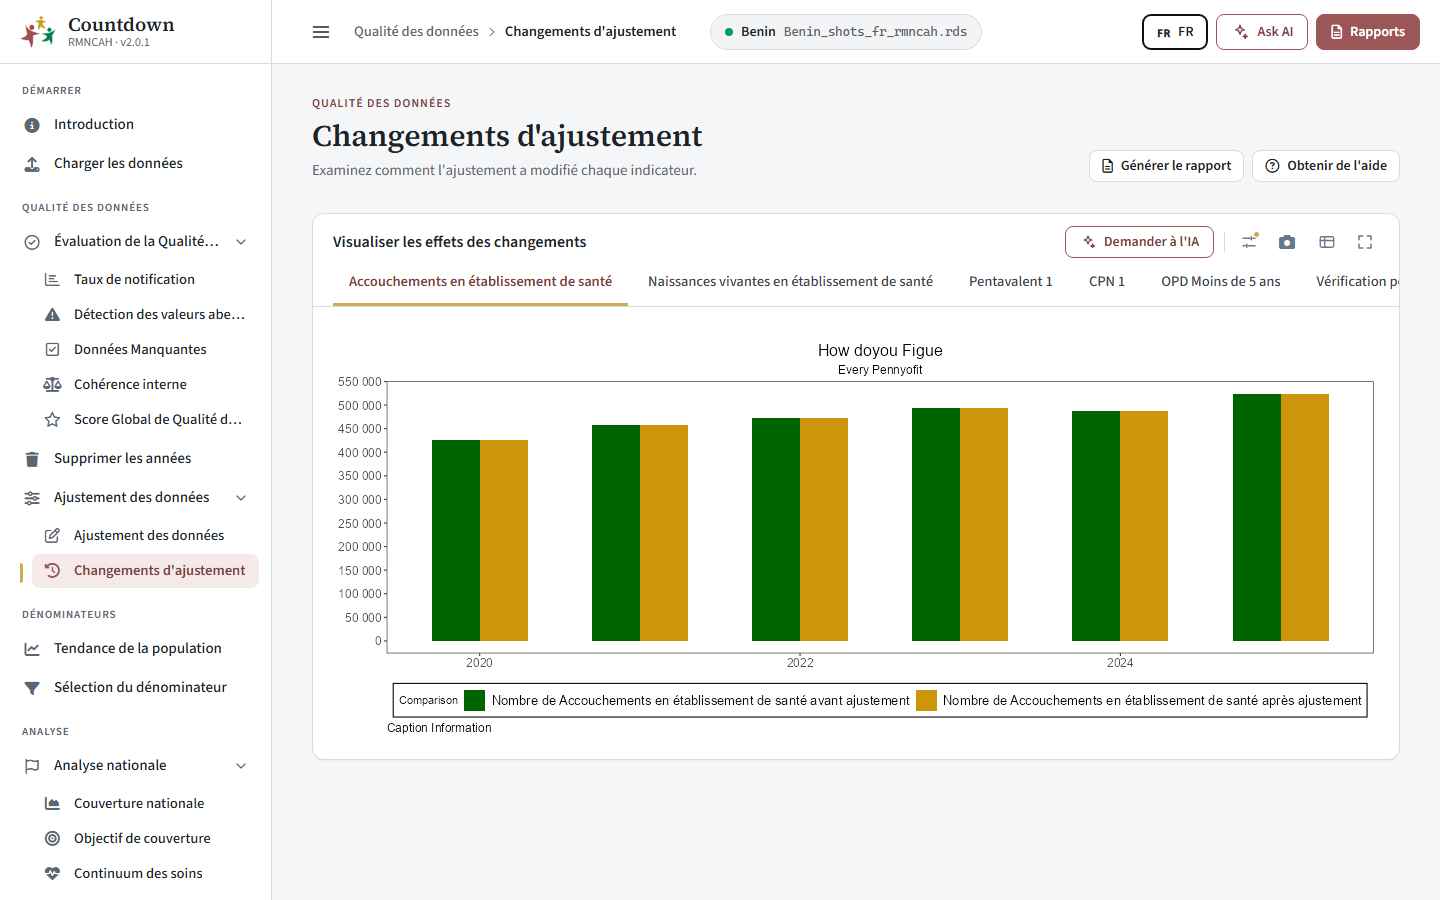 Changements d'ajustement comparant les valeurs avant et après ajustement
Lire la comparaison avant/après :
- Un faible écart entre les courbes (de petites différences avant et après) est normal et signifie que la notification était déjà presque complète.
- Un écart important ou un grand saut pour une année indique une année de notification très faible, ou une valeur aberrante à revoir dans la Détection des valeurs aberrantes. Indiquez le facteur k utilisé et la variation en pourcentage qu’il a produite (voir Rapport).
- L’effet est le plus marqué pour les services dont les taux de notification sont les plus faibles. Comparez avec la page Taux de notification.
Rapport
L’interprétation doit inclure le facteur d’ajustement sélectionné (facteur k) qui a été utilisé pour ajuster les rapports incomplets (si nécessaire, par service). Si le facteur par défaut est utilisé, signalez-le et expliquez ce que cela signifie pour le lecteur.
Rapportez la variation en pourcentage que l’ajustement a produite dans les nombres déclarés d’accouchements en établissement et de penta1 sur la période de six ans.
Vous pouvez souhaiter :
- Mettre en évidence l’année avec le plus grand impact de l’ajustement s’il y en a une.
- Interpréter si l’impact de l’ajustement sur les taux de couverture est grand ou petit.
- Faire la même description et les mêmes interprétations pour les vaccinations penta1.
Pièges courants
- Supprimer une année que vous devriez conserver raccourcit silencieusement toutes les tendances ultérieures.
- Utiliser un facteur k élevé pour masquer une mauvaise notification cache le problème au lieu de le corriger. Documentez votre choix.
- Les mois ou districts dont la notification est inférieure à 75 % ne restent pas sans ajustement (voir Règles de seuil de données critiques), mais l’ajustement ne peut pas retrouver ce qu’une notification très incomplète a manqué : envisagez de supprimer ces années.
Dans les applications
Supprimez les années non fiables
Sur la page Supprimer les années, sélectionnez les années à exclure et confirmez (voir Supprimer les années).
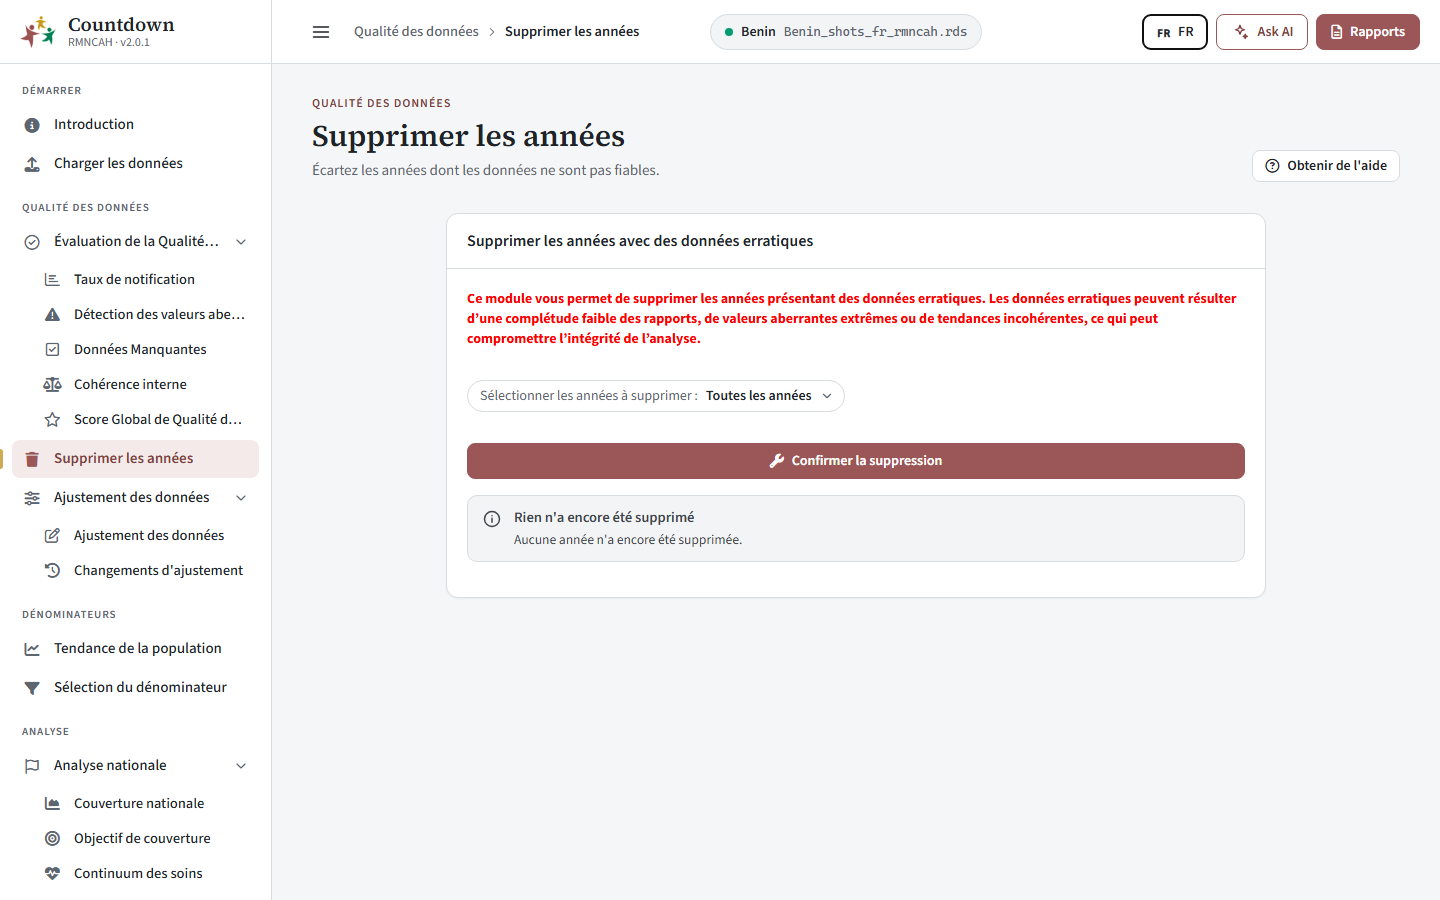 Écran Supprimer les années pour exclure les années non fiables
Choisissez le facteur k et ajustez les données
Les sorties et configurations pour cette phase sont gérées directement via la section Ajustement des données de DataSuite.
Dans l’interface utilisateur de ce module, sélectionnez la valeur spécifique du facteur jugée appropriée compte tenu de votre contexte national unique et de l’écosystème de vos établissements afin d’exécuter le pipeline de nettoyage des données (voir Ajustement des données).
Examinez les changements
Comparez les valeurs avant et après ajustement sur la page Changements d’ajustement.
Voir aussi
- Justification : Exhaustivité des rapports (avec le résumé des actions d’ajustement) et Valeurs aberrantes extrêmes
- Formules : ajustement des données
- Valeurs par défaut et seuils : ajustement des données
- Étape précédente : Évaluation de la qualité des données · Étape suivante : Évaluation et sélection du dénominateur