Abordagem de modelação bayesiana
Foi desenvolvido um modelo estatístico para estimar a cobertura em saúde a nível nacional e para regiões subnacionais até ao ano mais recente com dados, e para fazer previsões de curto prazo para os anos seguintes.
Em resumo
- Responde a: Qual é a melhor estimativa da cobertura em cada ano, a nível nacional e para as regiões subnacionais, até ao ano mais recente com dados e para os anos seguintes, e qual é a sua incerteza?
- Utiliza: dados de inquérito (os seus níveis de cobertura, ponderados pela sua incerteza) e dados de rotina das unidades de saúde (apenas a sua tendência de ano para ano, a partir da Cobertura nacional), com a pontuação média de qualidade dos dados do Countdown da Avaliação da qualidade dos dados.
- Produz: para a CPN4, os partos institucionais e a cobertura vacinal (três doses de pentavalente), uma melhor estimativa para cada ano com um intervalo de incerteza de 95%, a nível nacional e por região, e previsões de curto prazo. Passo seguinte: Avaliação da equidade (equiplots).
- Nas aplicações: Análise bayesiana (apenas aplicação RMNCAH).
Porque é importante
Informações fiáveis sobre os indicadores de cobertura em saúde são essenciais para monitorizar o progresso, orientar os programas e fundamentar decisões de política. No entanto, depender apenas de dados de inquérito e de rotina é frequentemente difícil. Os dados de rotina das unidades de saúde podem sofrer de subnotificação ou de qualidade de dados inconsistente, enquanto os dados de inquérito podem ser incertos ou não recentes.
Para responder a estes desafios, podem ser utilizados modelos estatísticos para produzir estimativas e previsões ao longo do tempo, combinando múltiplas fontes de dados e tendo em conta as suas limitações. Isto resulta em estimativas de cobertura para cada ano (entre pontos de dados e dados passados) com uma indicação do grau de certeza/incerteza sobre cada ano. Assim, os modelos permitem avaliações da cobertura em saúde mais completas, precisas e oportunas, especialmente em contextos com dados limitados.
O modelo é a ferramenta a utilizar quando os inquéritos são antigos ou poucos e os dados das unidades de saúde são imperfeitos, e é necessária uma única tendência defensável, por exemplo para um relatório de síntese.
Método
Produção de estimativas e previsões de curto prazo
O modelo analisa os dados disponíveis e identifica diferentes formas como a cobertura pode ter evoluído ao longo do tempo. Cada um destes percursos possíveis é designado por trajetória (ver a figura na secção sobre como são utilizados os dados de inquérito).
Para cada ano, é apresentada uma melhor estimativa (o valor central de todas as trajetórias) e um intervalo que mostra a incerteza (excluindo as possibilidades mais extremas nas margens).
Com base em análises globais, o modelo reflete que, ao longo do tempo, a cobertura tende a subir de níveis baixos para níveis elevados, seguindo uma tendência em forma de S, com períodos de progresso mais rápido ou mais lento consoante o que os dados indicam. Utiliza dados de inquérito e de rotina para escolher as trajetórias que correspondem ao observado. O modelo baseia-se também em tendências observadas noutras áreas com níveis de cobertura semelhantes.
Como são utilizados os dados de inquérito?
Os dados de inquérito ajudam a compreender a cobertura, mas trazem alguma incerteza. Isto acontece porque os inquéritos incluem apenas uma amostra da população, e não todas as pessoas, e podem ocorrer erros durante a recolha de dados.
Para tirar o melhor partido dos dados de inquérito, o modelo procura encontrar o equilíbrio certo, suavizando as oscilações aleatórias que provavelmente não são reais, sem deixar de captar os padrões importantes nos dados. Para tal, o modelo analisa o grau de incerteza de cada ponto de dados:
- Incerteza elevada: se um ponto de dados for muito incerto, terá menos impacto na cobertura estimada (o modelo atribui-lhe menos peso e tende a suavizá-lo).
- Fiabilidade elevada: se um ponto de dados for mais fiável, as estimativas ficarão mais próximas desse valor.
Para as regiões subnacionais, o modelo utiliza os dados de inquérito da região específica, quando disponíveis.
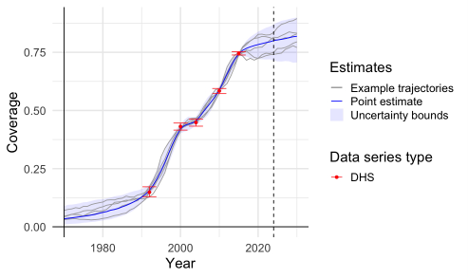 Trajetórias possíveis da cobertura ao longo do tempo com base nos dados de inquérito
Como são utilizados os dados de rotina?
As estimativas de cobertura a partir de dados de rotina podem ser enviesadas, pelo que o modelo trata-as de forma diferente dos dados de inquérito. Para os inquéritos, o modelo utiliza os níveis reais de cobertura. Por exemplo, se um inquérito indicar uma cobertura de 60% para um determinado ano, o modelo utiliza esse valor diretamente.
Em contrapartida, os dados de rotina podem ser enviesados devido a problemas como a notificação incompleta e inconsistências na recolha de dados. Por esse motivo, o modelo não se baseia nos níveis de cobertura observados nos dados de rotina. Em vez disso, o modelo concentra-se na tendência ao longo do tempo, ou seja, na forma como a cobertura varia de ano para ano.
- Exemplo: se os dados de rotina mostrarem a cobertura a aumentar de 50% em 2020 para 53% em 2021, o modelo interpreta isto como um aumento de 3 pontos percentuais. Se os dados de rotina mostrarem variações mais rápidas ou mais lentas do que o esperado, o modelo ajusta as estimativas, mas apenas na medida em que os dados sejam de confiança.
Ter em conta a qualidade dos dados
O modelo tem em conta a qualidade dos dados de rotina ajustando a incerteza das estimativas de tendência. As observações com menor qualidade de dados são tratadas como mais incertas e recebem menos peso na determinação das taxas reais de variação. Especificamente, a incerteza na taxa de variação estimada aumenta à medida que a pontuação média de qualidade dos dados do Countdown diminui. Consequentemente, os dados de menor qualidade exercem menos influência na taxa de variação modelada.
Interpretação
Exemplos ilustrativos
São produzidas estimativas para:
- A proporção de mulheres que recebem o mínimo recomendado de pelo menos quatro consultas de cuidados pré-natais durante a gravidez (CPN4).
- A proporção de nados-vivos que ocorrem numa unidade de saúde (Partos institucionais).
- A proporção de crianças que recebem as três doses recomendadas da vacina pentavalente (Cobertura vacinal).
Exemplo 1: cobertura da CPN4
Um exemplo do resultado para a cobertura da CPN4 a nível nacional é apresentado na figura abaixo. O gráfico mostra os dados de inquérito e os dados de rotina como pontos (cinzento para os dados de rotina, vermelho para os dados de inquérito).
A linha vermelha representa as estimativas pontuais modeladas, e as áreas sombreadas a vermelho representam os intervalos de incerteza de 95%.
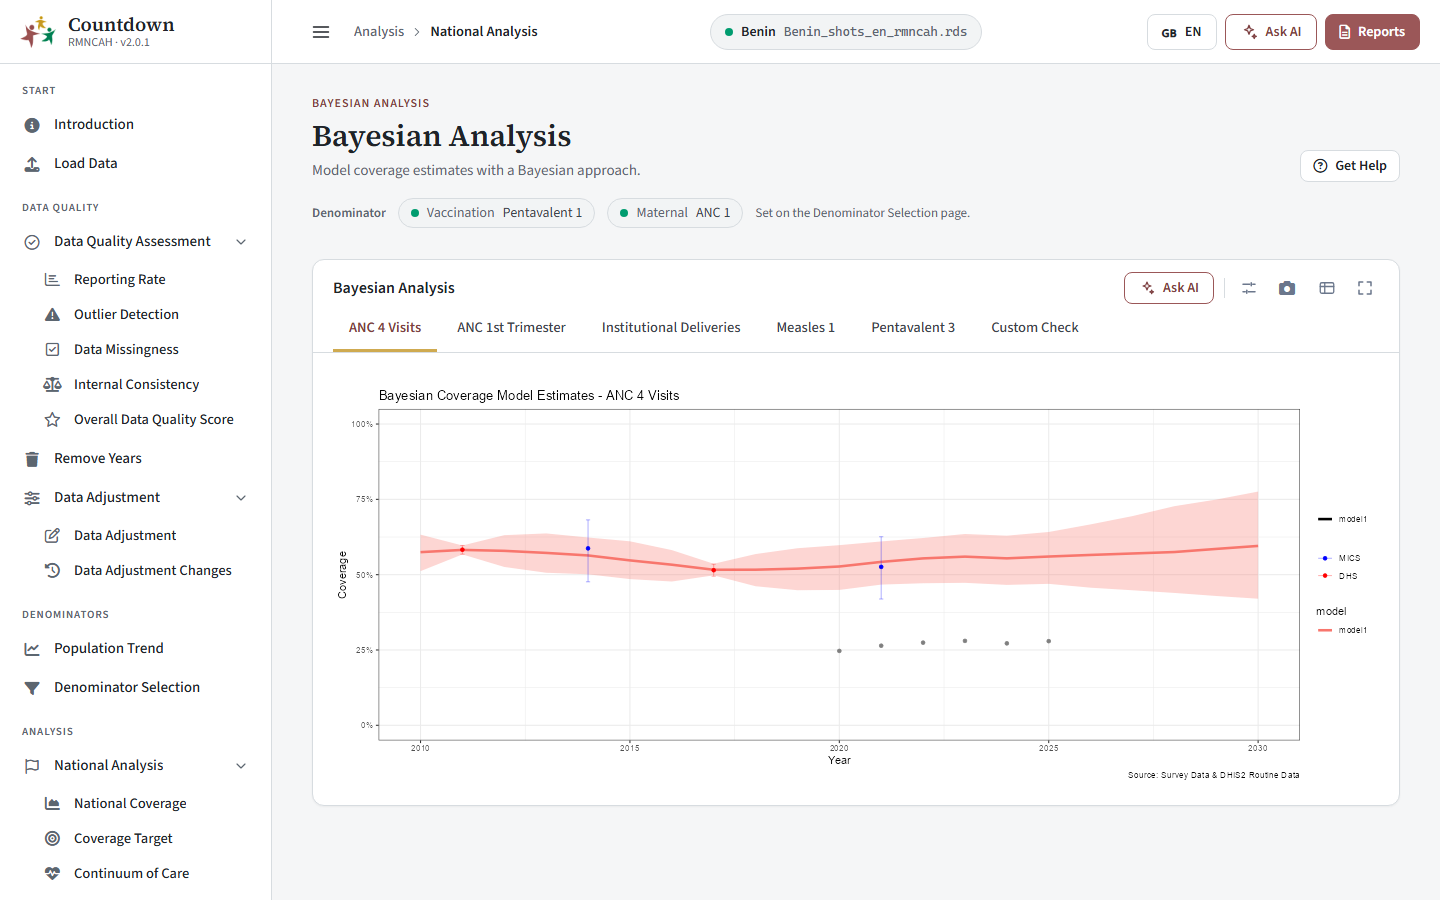 Cobertura nacional da CPN4 com dados de inquérito, dados de rotina e estimativas bayesianas
Exemplo 2: cobertura subnacional da CPN4
Os resultados de exemplo para a estimativa da cobertura subnacional para 2025 são apresentados na figura abaixo.
Os pontos vermelhos representam estimativas pontuais, e as linhas horizontais representam intervalos de incerteza de 95%.
 Estimativas da cobertura subnacional da CPN4 com intervalos de incerteza de 95%
Exemplo 3: dados e estimativas bayesianas
A figura abaixo mostra dados de exemplo e estimativas obtidas a partir do modelo para um indicador de cobertura em quatro regiões diferentes.
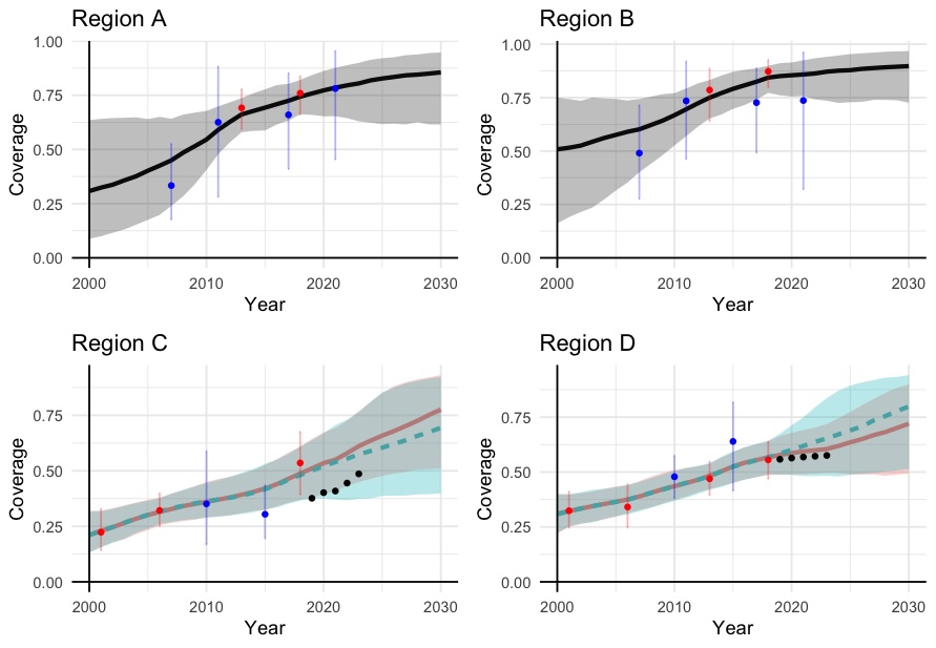 Dados de inquérito, dados de rotina e estimativas bayesianas para quatro regiões
Interpretação
- Os dados de inquérito do DHS e do MICS são apresentados a vermelho e azul, com barras verticais que indicam o grau de incerteza de cada ponto de inquérito. Os dados de rotina são apresentados a preto. As linhas representam as estimativas pontuais do modelo, com áreas sombreadas a destacar a incerteza (a vermelho se os dados de rotina foram incluídos, a preto/verde caso contrário).
- Os gráficos mostram que as estimativas do modelo geralmente seguem os dados de inquérito, a menos que um ponto de dados seja muito incerto e não corresponda à tendência geral.
- Por exemplo, na Região B, o ponto de inquérito MICS mais recente é mais baixo do que o esperado e muito incerto, pelo que as estimativas recentes do modelo não se alinham exatamente com esse inquérito.
- Observa-se também que os dados de rotina ajudam a indicar a rapidez com que a cobertura está a variar ao longo do tempo, particularmente após o inquérito mais recente, quando não existem novos dados de inquérito disponíveis.
- Região C: os dados de rotina mostram um aumento da cobertura. Em consequência, as estimativas que incluem os dados de rotina mostram uma taxa de variação mais rápida durante esse período, em comparação com as estimativas baseadas apenas nos dados de inquérito.
- Região D: os dados de rotina sugerem que a cobertura não aumentou recentemente, e as estimativas que incluem os dados de rotina refletem essa informação.
Leitura das estimativas
Uma faixa estreita significa que os dados concordam; uma faixa larga significa poucos pontos de dados ou dados em conflito. A estimativa segue uma subida em forma de S, típica da cobertura. Não encare o modelo como substituto de bons dados: se a pontuação de qualidade dos dados de rotina for baixa, a estimativa apoia-se mais nos inquéritos.
Armadilhas comuns
- Utilizar estimativas bayesianas sem indicar que são modeladas. Identifique-as como tal nos relatórios.
Nas aplicações
Abra a Análise bayesiana
Na aplicação RMNCAH, o grupo Análise bayesiana da barra lateral tem duas entradas: Análise nacional e Análise subnacional (regiões). A aplicação Vaxx não tem estas páginas.
Escolha um separador de indicador
Cada separador é um indicador para o qual o modelo está definido: a Análise bayesiana apresenta a lista.
Leia o gráfico
A linha central é a melhor estimativa e a faixa é o intervalo de incerteza; Baixar Gráfico e Baixar Dados estão na barra de ferramentas. Identifique as estimativas como modeladas quando as utilizar em relatórios.
Ver também
- Análise bayesiana no guia da aplicação
- Avaliação da qualidade dos dados: a pontuação de qualidade dos dados que determina o peso da tendência dos dados de rotina
- Passo anterior: Cobertura nacional
- Passo seguinte: Avaliação da equidade (equiplots)